扫描 A 的 f/g 双状态计数 DP:g 记最后一段以当前字符结尾的方案,接段尾与开新段两路合并,滚动加匹配列倒序把空间压到 O(mk)。
OJ: roj
题目 ID: 3632
难度:普及+/提高-
标签:动态规划字符串计数DP
创建: 2026-10-02 11:31
更新: 2026-10-10 11:30
形式化题目
给定字符串
等价地,选
由于每个子串非空、不重叠且按序使用,被选中的字符保持它们在
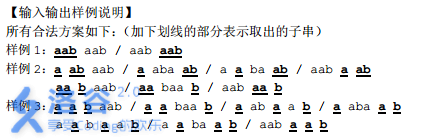
样例(aabaab,aab)的三个答案:
:一整段必须等于 aab,它在aabaab中出现于、 ,共 2 种。 : 只能拆成 a+ab或aa+b。a+ab:a取自位置, ab出现在、 ,前段须整体位于后段左侧,得 种; aa+b:aa出现在、 , b在,得 种。合计 7 种。 :只能拆 a+a+b。前两个a的位置对共 6 种,可配 ,其余 5 对只能配 ,共 7 种。
正解
思路
1. 朴素做法与瓶颈
最朴素的做法是枚举
但"只用一个
2. 状态定义
:考虑 的前 个字符,能拼出 的前 个字符、共取 段的方案数( 用不用都可以); :在 的基础上,额外要求第 段以 结尾( 必被选中、且它匹配 )的方案数。只有 时 才可能非零。
3. 转移与初始化
当
- 接段尾:上一步
已匹配 且就在第 段里,正是 的定义; - 开新段:第
段只含 ,前 个字符只需用 段拼出 的前 位,即 ; 时 不可能匹配 , 。
初始化:
对
样例 viz_render.py 教学版 DP 复算,与 main.py 结果一致):
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 0 | 0 | 0 | 0 |
| 1 | 0 | 1 | 0 | 0 |
| 2 | 0 | 2 | 1 | 0 |
| 3 | 0 | 2 | 1 | 1 |
| 4 | 0 | 3 | 1 | 1 |
| 5 | 0 | 4 | 2 | 1 |
| 6 | 0 | 4 | 2 | 2 |
行是 a 就
4. 滚动数组与更新顺序
状态数
滚两层: 只依赖 与 ,逐字符保留"上一个字符"和"当前字符"两层即可(代码中 g_prev/g_cur交换);原地累加: 对 只增不减,一维数组原地更新;非匹配列 , 行保持不变(仍指向同一 list,无需整行复制)。
由此带出一个实现上必须回答的问题:同一轮内 cols_of(MOD 代替逐元素取模。
(代码里下标 0-based:f[col][t] 对应 seg_one_start 即 f[len(B)][k - 1]。)
代码
/**
* Author by Rainboy blog: https://rainboylv.com github: https://github.com/rainboylvx
* rbook: -> https://rbook.roj.ac.cn https://rbook2.roj.ac.cn
* rainboy的学习导航网站: https://idx.roj.ac.cn
* create_at: 2026-10-10 11:30
* update_at: 2026-10-10 11:30
*/
#include <bits/stdc++.h>
using namespace std;
typedef long long ll;
const int MOD=1000000007;
int main(){ios::sync_with_stdio(false);cin.tie(nullptr); int n,m,k; if(!(cin>>n>>m>>k)) return 0; string A,B; cin>>A>>B; vector<vector<int> > cols(256); for(int i=0;i<m;i++) cols[(unsigned char)B[i]].push_back(i+1); vector<vector<int> > f(m+1, vector<int>(k)), gprev(m+1, vector<int>(k)); for(int idx=0;idx<n;idx++){unsigned char ch=A[idx]; vector<vector<int> > gcur(m+1, vector<int>(k)); vector<int> &vc=cols[ch]; for(int id=(int)vc.size()-1; id>=0; id--){int col=vc[id]; for(int t=0;t<k;t++){ll y = (t==0 ? (col==1?1:0) : f[col-1][t-1]); ll v = gprev[col-1][t] + y; if(v>=MOD) v-=MOD; int joined=v; ll nf=f[col][t]+joined; if(nf>=MOD) nf-=MOD; f[col][t]=nf; gcur[col][t]=joined;}} gprev.swap(gcur);} cout<<f[m][k-1]<<'\n'; return 0;}#!/usr/bin/env python3
# Author by Rainboy blog: https://rainboylv.com github: https://github.com/rainboylvx
# rbook: -> https://rbook.roj.ac.cn https://rbook2.roj.ac.cn
# rainboy的学习导航网站: https://idx.roj.ac.cn
# create_at: 2026-10-02 12:05
# update_at: 2026-10-04 13:32
import sys
MOD = 1000000007
def count_plans(A: str, B: str, k: int) -> int:
"""从 A 中取 k 个互不重叠子串按序拼出 B 的方案数(对 MOD 取模)。
f[j][t]:已扫描的 A 前缀能拼出 B[:j]、取 t+1 段的总方案数(A 当前字符用不用均可);
g[j][t]:在 f 的基础上额外要求最后一段以刚扫过的那个 A 字符匹配 B[j-1] 结尾。
A[i] 与 B[j-1] 匹配时 g 才非零,转移恰有两种:接在当前段尾用 g[j-1][t],
让 A[i] 开新段用 f[j-1][t](即凑 B[:j-1] 只用 t 段,新段从 A[i] 起步)。
"""
# B 中每个字符出现的列号(1-based):扫描 A 时只访问可能匹配的列
cols_of: dict[str, list[int]] = {}
for col, ch in enumerate(B, 1):
cols_of.setdefault(ch, []).append(col)
zero = [0] * k
# f[0][t] 恒为 0:空串 B[:0] 取正段数不可能;第 0 列永远不更新
f: list[list[int]] = [[0] * k for _ in range(len(B) + 1)]
g_prev: list[list[int]] = [zero] * (len(B) + 1) # 上一个 A 字符处的 g
for ch in A:
# 列号从右往左更新,读到的 f[col-1] 才会停留在上一个字符的那一层
g_cur: list[list[int]] = [zero] * (len(B) + 1)
for col in reversed(cols_of.get(ch, ())):
seg_one_start = 1 if col == 1 else 0 # f[·][0][0]:0 段拼出空串恰有 1 种
# 逐段位合并"接段尾 + 开新段";两数都 < MOD,和减一次 MOD 即回 [0, MOD)
joined = [
v - MOD if (v := x + y) >= MOD else v
for x, y in zip(g_prev[col - 1], [seg_one_start] + f[col - 1][:k - 1])
]
f[col] = [v - MOD if (v := x + y) >= MOD else v for x, y in zip(f[col], joined)]
g_cur[col] = joined
g_prev = g_cur
return f[len(B)][k - 1]
def solve() -> None:
data = iter(sys.stdin.buffer.read().split())
n, m, k = int(next(data)), int(next(data)), int(next(data)) # 题面的 |A|、|B| 与段数,转移只依赖 k
print(count_plans(next(data).decode(), next(data).decode(), k))
if __name__ == "__main__":
solve()复杂度
- 时间复杂度:
上限,与正解同阶;实现只在匹配列做转移,实际为"匹配对数 ",最大单测( ,匹配对 99400)本地实测 0.635s。 - 空间复杂度:
: 一维 , 两层,非匹配列共享零数组;实测峰值约 17MB(含 Python 解释器),远低于 32MB。 - 实测:数据仓 10 组真实数据全部 PASS,最慢 0.678s;Python 满规模无 TLE/MLE 风险,若
再放大一个量级则需注意。
总结
- "按序拼出
"等价于与 逐位对照,所以外层扫描 :不重叠、有序都由扫描顺序天然保证。 - 单靠
不知道最后一段的右端点,补 (最后一段以 结尾)后,转移恰好是两路:接段尾用 、开新段用 。 滚两层、 原地累加、匹配列倒序更新、只访问匹配列——四件事把 三维表压成 且在 Python 中跑进时限。
图示解析
这张图串起本题从朴素枚举到最终答案的主线:
枚举 2k 个边界 -> 组合爆炸,不可行
`- 关键观察:按序拼接 = 与 B 逐位对照,外层扫 A 定序
`- 补状态 g[i][j][p]:接段尾用 g,开新段用 f,两路合并
`- g 滚两层 + f 原地累加 + 匹配列倒序 -> 答案 f[n][m][k]先看每个节点记录的推理结论,再顺着 `- 分支检查它如何自然导出下一步:每一层都只解决了上一层留下的一个瓶颈。图中不含完整 DP 表与代码细节,具体格子的转移仍以正文表格为准。