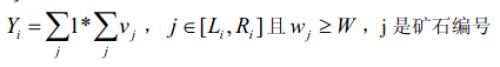总检验值 y(W) 随阈值 W 单调不增:前缀和把一次求值压到 O(n+m),二分找到越过标准值 S 的分界点,答案只在分界点两侧产生。
OJ: roj
题目 ID: 3592
难度:普及+/提高-
标签:二分答案前缀和单调性python
创建: 2026-10-02 09:28
更新: 2026-10-10 11:30
形式化题目
给定长度
选定参数
其中
样例
| 区间 | 区间内 |
块数 |
价值和 |
检验值 |
|---|---|---|---|---|
| 4 号、5 号 | 2 | 10 | 20 | |
| 4 号 | 1 | 5 | 5 | |
| 无 | 0 | 0 | 0 |
注意检验值是「块数 × 价值和」,不是单纯的价值和:
正解
思路
按定义计算就是:枚举
观察一:
| 各区间 |
|||
|---|---|---|---|
| 1 | (5, 25) (3, 15) (1, 5) | 175 | 160 |
| 2 | (4, 20) (3, 15) (1, 5) | 130 | 115 |
| 3 | (3, 15) (2, 10) (1, 5) | 70 | 55 |
| 4 | (2, 10) (1, 5) (0, 0) | 25 | 10 |
| 5 | (1, 5) (0, 0) (0, 0) | 5 | 10 |
| 6 | (0, 0) (0, 0) (0, 0) | 0 | 15 |
观察二:单次求值降到
:该位置对「块数」的贡献; :该位置对「价值和」的贡献。
分别做前缀和 sum 一次收掉。前缀和把「区间查询」的
观察三:答案只在分界点两侧产生。 定义谓词 lo)为第一个满足
一侧: ,差值 随 变小而增大,最小在 ; 一侧( 时): ,差值 随 减小而增大,最小在 。
所以答案
代码
/**
* Author by Rainboy blog: https://rainboylv.com github: https://github.com/rainboylvx
* rbook: -> https://rbook.roj.ac.cn https://rbook2.roj.ac.cn
* rainboy的学习导航网站: https://idx.roj.ac.cn
* create_at: 2026-10-10 11:30
* update_at: 2026-10-10 11:30
*/
#include <bits/stdc++.h>
using namespace std;
typedef long long ll;
struct Ore { ll w, v; };
struct Query { int l, r; };
vector<Ore> ores; vector<Query> qs; ll target; int n, m;
ll evaluate_value(ll limit) {
vector<ll> cnt(n + 1), sv(n + 1);
for (int i = 1; i <= n; i++) {
cnt[i] = cnt[i - 1] + (ores[i - 1].w >= limit);
sv[i] = sv[i - 1] + (ores[i - 1].w >= limit ? ores[i - 1].v : 0);
}
ll total = 0;
for (int i = 0; i < m; i++) total += (cnt[qs[i].r] - cnt[qs[i].l - 1]) * (sv[qs[i].r] - sv[qs[i].l - 1]);
return total;
}
int main(){ ios::sync_with_stdio(false); cin.tie(nullptr); if(!(cin>>n>>m>>target)) return 0; ores.resize(n); qs.resize(m); ll mx=0; for(int i=0;i<n;i++){cin>>ores[i].w>>ores[i].v; mx=max(mx,ores[i].w);} for(int i=0;i<m;i++) cin>>qs[i].l>>qs[i].r; ll lo=1,hi=mx+2; while(lo<hi){ll mid=(lo+hi)/2; if(evaluate_value(mid)>target) lo=mid+1; else hi=mid;} ll a=evaluate_value(lo), b=evaluate_value(lo-1); cout << min(llabs(a-target), llabs(b-target)) << '\n'; return 0; }#!/usr/bin/env python3
# Author by Rainboy blog: https://rainboylv.com github: https://github.com/rainboylvx
# rbook: -> https://rbook.roj.ac.cn https://rbook2.roj.ac.cn
# rainboy的学习导航网站: https://idx.roj.ac.cn
# create_at: 2026-10-02 09:32
# update_at: 2026-10-02 09:32
import sys
from collections.abc import Iterator
from itertools import accumulate
def read_ints() -> Iterator[int]:
"""逐行产出输入里的全部整数,避免一次性物化整份输入。"""
for line in sys.stdin.buffer:
yield from map(int, line.split())
def evaluate(limit: int, ores: list[tuple[int, int]], queries: list[tuple[int, int]]) -> int:
"""给定阈值 W = limit,用两组前缀和 O(n+m) 算出总检验值 y(W)。
区间检验值 = 区间内 w >= W 的矿石块数 × 这些矿石的价值和,
两组前缀和相减即得区间内的块数与价值和。
"""
cnt = [0] + list(accumulate(w >= limit for w, _ in ores)) # 入选块数前缀和
sv = [0] + list(accumulate(v if w >= limit else 0 for w, v in ores)) # 入选价值和前缀和
return sum((cnt[r] - cnt[l - 1]) * (sv[r] - sv[l - 1]) for l, r in queries)
def min_gap(ores: list[tuple[int, int]], queries: list[tuple[int, int]], target: int) -> int:
"""二分第一个 y(W) <= target 的 W(分界点),答案只可能在它与前一个 W 取到。
W 变大时入选矿石只减不增,y(W) 单调不增;越过 target 之后差值只会更大。
"""
max_w = max(w for w, _ in ores)
lo, hi = 1, max_w + 2 # hi 处已无矿石入选,y = 0 <= target,保证二分有分界点
while lo < hi:
mid = (lo + hi) // 2
if evaluate(mid, ores, queries) > target:
lo = mid + 1 # y 还太高,往右找
else:
hi = mid
return min(abs(evaluate(w, ores, queries) - target) for w in (lo, lo - 1))
def solve() -> None:
data = iter(read_ints())
n, m, target = next(data), next(data), next(data)
ores = [(next(data), next(data)) for _ in range(n)] # (w_i, v_i)
queries = [(next(data), next(data)) for _ in range(m)] # [L_i, R_i]
print(min_gap(ores, queries, target))
if __name__ == "__main__":
solve()复杂度
- 时间
:每次 evaluate两组前缀和扫块矿石、生成器求和扫 个区间共 ;二分区间 , 时至多 轮二分求值,另加最后 2 次候选求值。与 C++ 正解(前缀和 + 二分答案)同阶。 - 空间
:矿石与区间各一个列表, evaluate内两组长度的前缀和数组随返回释放。输入用逐行生成器读入,不物化整份 token;实测最大用例峰值约 82MB(Python 对象开销),32MB 限制下有 MLE 风险——C++ 落地时前缀和改用两个 long long数组,即可压回紧凑的内存。
总结
- 检验值定义为「区间内入选矿石的块数 × 价值和」,总检验值
关于阈值 单调不增——这是全题唯一的性质支点。 - 单调性带来两件事:单次求值用前缀和压到
,而「最接近 的 」用二分答案压到 次求值。 - 越过分界点
后,无论 再怎么取,差值只会更大,因此答案只需在 与 两个点里取较小者。 - 整体
,与标准 C++ 正解同阶;Python 实现 20 组真实数据全部通过。