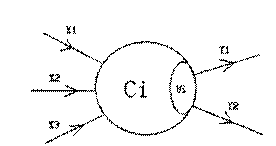
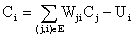把分层神经网络看成 DAG,按拓扑序一次遍历:非输入层先扣阈值,只有 C>0 的兴奋神经元才把状态乘边权传给下游,最后输出出度为 0 且状态为正的神经元。
OJ: roj
题目 ID: 3524
难度:普及+/提高-
标签:图论拓扑排序DAGpython
创建: 2026-10-02 05:16
更新: 2026-10-10 11:30
形式化题目
给定一张分层有向图
每个神经元的状态按公式
更新,并遵守兴奋规则:
时神经元兴奋,下一秒向所有后继发送强度为 的信号, 后继 把 计入自己的求和; 时神经元平静,不发送任何信号。
输入层神经元由外部激发,其当前状态 NULL。
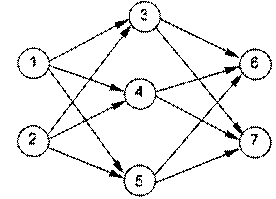
题面样例的网络结构如下图(框内为给定初值
flowchart LR
    n1["神经元 1:输入层 C=1"] -->|W=1| n3["神经元 3:U=1"]
    n1 -->|W=1| n4["神经元 4:U=1"]
    n1 -->|W=1| n5["神经元 5:U=1"]
    n2["神经元 2:输入层 C=1"] -->|W=1| n3
    n2 -->|W=1| n4
    n2 -->|W=1| n5
图中 1、2 号是输入层,3、4、5 号没有出边、构成输出层; 每个输出神经元都同时收到 1 和 2 两个上游的信号,这正是「多条边汇合后再扣阈值」 的最小例子,下面的逐点计算表会完整展示这个过程。
正解
思路
朴素做法:逐秒同步模拟。
最直接的写法是按题面时间线走:每一秒,所有兴奋神经元同时沿出边发送
瓶颈。 两种朴素写法反复回答的是同一个问题:「神经元 i 的最终状态是多少」。
而这个答案只依赖前驱的最终状态——前驱一旦定型,i 的答案就永远不变。
逐秒模拟却在后续每一轮里让已经定型的点继续参与判断,
关键观察:分层 ⇒ DAG ⇒ 拓扑序一次遍历。
题面规定网络分层、信号只沿「上一层 → 下一层」流动,所以图中没有环。
DAG 存在拓扑序:每个点排在它所有前驱之后。按拓扑序处理时,点 i 被弹出的
那一刻所有前驱都已定型,而且兴奋的前驱离场时已经把 i,
平静的前驱什么也没加——此时 state[i] 恰好等于
两个必须钉死的细节
- 输入层不套公式:没有入边的神经元保持题面给定的初值、不扣阈值。
公式里的
对输入层为空,它的状态是被外部直接激发出来的; 若对它也减 ,单点网络( )会算出 而丢失答案。 - 平静的点也要走完出边:它不发信号,但必须给每个后继的入度减一,
否则后继永远等不齐上游、不会入队,它的状态(可能恰好是
)就漏算了。
落地成一次遍历。 实现用 Kahn 入度法取得拓扑序:读完边后,先把入度大于 state[v] += state[u] * w,
然后无条件把
样例推演。 下表按拓扑序展示样例中每个神经元的计算过程, 列依次是:所属层、上游兴奋信号的加权和、阈值、最终状态、是否兴奋。
| 神经元 | 层 | 上游贡献 |
阈值 |
最终状态 |
是否兴奋 |
|---|---|---|---|---|---|
| 1 | 输入层 | 不适用(外部给定) | 不扣减 | 是 | |
| 2 | 输入层 | 不适用(外部给定) | 不扣减 | 是 | |
| 3 | 输出层 | 是 | |||
| 4 | 输出层 | 是 | |||
| 5 | 输出层 | 是 |
读法:先看输入层两行,初值原样保留且不扣阈值;再看 3 号,
它的两个上游都兴奋,各送来 3 1、4 1、5 1。若某个输出神经元的上游全部平静,
它收到的贡献为 NULL。
代码
/**
* Author by Rainboy blog: https://rainboylv.com github: https://github.com/rainboylvx
* rbook: -> https://rbook.roj.ac.cn https://rbook2.roj.ac.cn
* rainboy的学习导航网站: https://idx.roj.ac.cn
* create_at: 2026-10-10 11:30
* update_at: 2026-10-10 11:30
*/
#include <bits/stdc++.h>
using namespace std;
typedef long long ll;
int n, p;
int state[105]; // 神经元状态
int limit[105]; // 阈值
vector<pair<int, int> > adj[105]; // (v, w)
int indeg[105], outdeg[105];
int remain[105];
// 按拓扑序推进网络
void simulate() {
vector<int> ready;
for (int i = 1; i <= n; i++) {
remain[i] = indeg[i];
if (indeg[i] == 0) ready.push_back(i);
}
while (!ready.empty()) {
int u = ready.back(); ready.pop_back();
for (size_t i = 0; i < adj[u].size(); i++) {
int v = adj[u][i].first, w = adj[u][i].second;
if (state[u] > 0) state[v] += state[u] * w;
remain[v]--;
if (remain[v] == 0) ready.push_back(v);
}
}
}
int main() {
ios::sync_with_stdio(false);
cin.tie(nullptr);
cin >> n >> p;
for (int i = 1; i <= n; i++) {
cin >> state[i] >> limit[i];
}
for (int i = 0; i < p; i++) {
int a, b, w;
cin >> a >> b >> w;
adj[a].push_back(make_pair(b, w));
indeg[b]++;
outdeg[a]++;
}
// 阈值先扣:有上游的神经元减 U_i
for (int i = 1; i <= n; i++)
if (indeg[i]) state[i] -= limit[i];
simulate();
bool any = false;
for (int i = 1; i <= n; i++) {
if (outdeg[i] == 0 && state[i] > 0) {
cout << i << " " << state[i] << "\n";
any = true;
}
}
if (!any) cout << "NULL\n";
return 0;
}#!/usr/bin/env python3
# Author by Rainboy blog: https://rainboylv.com github: https://github.com/rainboylvx
# rbook: -> https://rbook.roj.ac.cn https://rbook2.roj.ac.cn
# rainboy的学习导航网站: https://idx.roj.ac.cn
# create_at: 2026-10-02 05:20
# update_at: 2026-10-02 05:20
import sys
from collections.abc import Iterator
def simulate(state: list[int], adj: list[list[tuple[int, int]]], indeg: list[int]) -> None:
"""按拓扑序推进网络:兴奋(状态大于 0)的神经元把状态乘边权送给下游,
后代收齐全部上游信号后即得到终值(阈值已在 solve 中预扣)。"""
remain = indeg[:] # 每个神经元还剩几个上游没处理
ready = [i for i in range(1, len(state)) if indeg[i] == 0]
while ready:
u = ready.pop()
for v, w in adj[u]:
if state[u] > 0: # 平静的神经元不发信号,只完成入度计数
state[v] += state[u] * w
remain[v] -= 1
if remain[v] == 0: # 上游全部处理完,可以计算 v 的最终状态
ready.append(v)
def solve() -> None:
data: Iterator[int] = iter(map(int, sys.stdin.buffer.read().split()))
n, p = next(data), next(data)
state = [0] * (n + 1) # 神经元状态 C_i;非输入层初值必为 0
limit = [0] * (n + 1) # 阈值 U_i
for i in range(1, n + 1):
state[i] = next(data)
limit[i] = next(data)
adj: list[list[tuple[int, int]]] = [[] for _ in range(n + 1)]
indeg = [0] * (n + 1)
outdeg = [0] * (n + 1)
for _ in range(p):
a, b, w = next(data), next(data), next(data)
adj[a].append((b, w))
indeg[b] += 1
outdeg[a] += 1
# 阈值先扣:有上游的神经元按公式减 U_i;输入层(无上游)保持题面给定的初值
for i in range(1, n + 1):
if indeg[i]:
state[i] -= limit[i]
simulate(state, adj, indeg)
# 输出层 = 没有出边的神经元,按编号从小到大只报状态大于 0 的
out = [f"{i} {state[i]}" for i in range(1, n + 1) if outdeg[i] == 0 and state[i] > 0]
print('\n'.join(out) if out else 'NULL')
if __name__ == "__main__":
solve()复杂度
- 时间复杂度:
。每个神经元入栈、出栈各一次,每条边只在起点 弹出时扫描一次,预扣阈值是一次 扫描;比朴素逐秒模拟的 少掉了所有重复轮次。 - 空间复杂度:
。邻接表 ,状态、入度、出度等工作数组 与就绪栈各 。
总结
- 「分层网络 + 只沿层间传递」= DAG:把按时间逐秒传播改写成
按依赖拓扑序一次遍历,每个神经元的终值只算一次,复杂度
。 - 兴奋规则是全题唯一陷阱:
才发信号,但无论是否兴奋, 后继的入度都要照常减一,否则下游等不齐上游而漏算。 - 输入层状态由题面给定、不扣阈值;输出层就是出度为
的神经元, 按编号升序输出其中状态大于 的,否则输出 NULL。