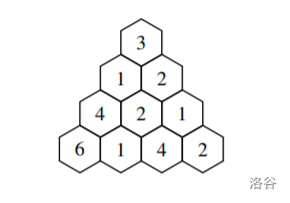
倍增把三角形按 2 的幂拆块求最值:主解只用正三角形,6 个同尺寸块补上空隙(图解 + 2 层滚动,内存稳定);备选引入倒三角形做 DAG 分解(小 k 更快但内存高)。
OJ: luogu
题目 ID: P6648
难度:提高
标签:倍增ST表区间最值
创建: 2026-07-16 18:28
更新: 2026-10-30 17:15
题意
给定边长为
解法总览
两条路线都是倍增 +
| 解法 | 核心观察 | 时间 | 空间 | 适用场景 | 对应代码 |
|---|---|---|---|---|---|
| 一、纯正三角形 + 6 块查询(主解) | 每层用 6 块补空隙,倍增到不超过 k 的最大 2 的幂,查询时用 6 块拼出 k 边长 | 大多数情况的首选:易理解、内存稳定 | main.cpp / main.py |
||
| 二、正/倒三角形 DAG 分解(备选) | 把「边长 |
int/格, |
想看清「用倒三角形补空隙」这条路线; |
main2.cpp |
两条都正确、复杂度同阶。解法一(纯正 6 块)在内存上始终占优、也更容易理解,是实际提交的首选;解法二(正/倒 DAG)只在
暴力解法
先看一个直接按题意扫描的朴素解:
#include <bits/stdc++.h>
using namespace std;
const int MAXN = 105;
int n, k;
int a[MAXN][MAXN];
int main() {
ios::sync_with_stdio(false);
cin.tie(nullptr);
cin >> n >> k;
for (int i = 1; i <= n; i++) {
for (int j = 1; j <= i; j++) {
cin >> a[i][j];
}
}
long long answer = 0;
// 枚举每个大小为 k 的正三角形的顶点。
for (int i = 1; i + k - 1 <= n; i++) {
for (int j = 1; j <= i; j++) {
// 注意必须用极小值初始化: 权值可能全为负, 用 0 会把答案抬成 0。
int best = INT_MIN;
// 直接把这个子三角形里的所有点扫一遍,取最大值。
for (int dx = 0; dx < k; dx++) {
for (int dy = 0; dy <= dx; dy++) {
best = max(best, a[i + dx][j + dy]);
}
}
answer += best;
}
}
cout << answer << '\n';
return 0;
}暴力对每个子三角形逐行扫一遍取最大值,总复杂度
解法一:纯正三角形 + 6 块查询(主解)
思路
从一维 ST 表说起
先估一下暴力:边长
这和一维 RMQ 的结构一样。RMQ 先预处理所有长度为
这里的“拼”是指拿若干个小三角形把目标三角形盖住:块之间允许重叠,只要目标里每个格子至少落在一个块内,这些小三角形的最大值就等于目标三角形的最大值。于是问题变成一句很具体的话:用边长为
一维区间两块就够,三角形不够。下面会看到,构建和查询用的是同一套答案:6 个边长相同的块,具体位置由目标边长决定。
为什么 3 个角块不够

左图是边长 8 的三角形,摆 3 个边长 4 的块,三个角都盖住,中间仍空出一个边长 3 的倒三角(红点)。
补法很直接:再放 3 个块,如右图。这 3 个补块的边长还是 4,和角块完全一样,只是上顶点往中间挪了半个边长。整个算法因此只有一种块尺寸,不需要为补丁另造结构。
想自己核对每个块的落点,可以打开6 块交互演示:拖动滑块改
构建:从边长
设已知所有
- 三个角:
、 、 ; - 三个补块:
、 、 。
取这 6 个
左边是边长
half、quarter,层数 t == 1 时跳过补块。
查询:同一套模板,换个偏移
表只建到
- 三个角:
、 、 ; - 三个补块:
、 、 ,其中 。
两个边界值得单独记一下:
恰是 的幂时 、 ,6 个块塌成 1 块,直接读表; 时块边长就是 1,没有补块,对应代码里的 if (lg >= 1)。
| 代码变量 | 含义 | 值 |
|---|---|---|
half |
构建时的块边长 |
|
quarter |
构建时的补块偏移 |
|
lg、block |
查询时的块边长 | |
cha |
查询时的补块偏移 |
为什么只要两层表
每一层只依赖上一层,所以两层表轮换就够:f[pre] 读、f[cur] 写,算完 swap(pre, cur) 进入下一层。全程内存是恒定的两层
代价是必须先把倍增推到
代码
/**
* Author by Rainboy blog: https://rainboylv.com github: https://github.com/rainboylvx
* rbook: -> https://rbook.roj.ac.cn https://rbook2.roj.ac.cn
* rainboy的学习导航网站: https://idx.roj.ac.cn
* create_at: 2026-10-27 14:34
* update_at: 2026-10-30 17:09
*/
// main.cpp:P6648 解法一(主解),纯正三角形倍增 + 查询时用 6 块拼出目标三角形。
// 全程只处理正三角形,不做 DAG 递归分解,只滚动保留 2 层表。
// 时间 O(n^2 log k),空间 O(n^2) 且只有 2 层,与 k 无关。
#include <bits/stdc++.h>
using namespace std;
typedef long long ll;
const int MAXN = 3005;
// f[p][i][j]:p = 0/1 两层轮换;(i,j) 为上顶点、边长 2^t 的三角形内的最大值。
// 单层 3005 x 3005 的 int 约 36 MB,两层合计约 72 MB。
int f[2][MAXN][MAXN];
int n, k; // 三角形大小、要求的子三角形边长;都不超过 3000,只当长度和下标用,所以用 int
int lg; // 不超过 k 的最大 2 的幂的指数
int block; // block = 2^lg,查询时用的块边长
int main() {
ios::sync_with_stdio(false);
cin.tie(nullptr);
cin >> n >> k;
lg = 0;
while ((2 << lg) <= k) {
lg++;
}
block = 1 << lg;
for (int i = 1; i <= n; i++) {
for (int j = 1; j <= i; j++) {
cin >> f[0][i][j];
}
}
// 倍增:从边长 1 逐层推到边长 block。
// 边长 2^t 的三角形用 6 个边长 2^(t-1) 的块盖住:三个在角上(偏移 half),
// 三个往中间挪(偏移 quarter),把中间那块倒三角空隙补上。
// pre / cur 是 f 的两层下标;算完 swap 一下,刚写完的一层就变成下一轮的读表。
int pre = 0;
int cur = 1;
for (int t = 1; t <= lg; t++) {
int half = 1 << (t - 1); // 这一层的块边长
int quarter = (t >= 2) ? (1 << (t - 2)) : 0; // 补块偏移;t = 1 时没有补块
for (int i = 1; i + (1 << t) - 1 <= n; i++) {
for (int j = 1; j <= i; j++) {
int best = f[pre][i][j];
best = max(best, f[pre][i + half][j]);
best = max(best, f[pre][i + half][j + half]);
if (t > 1) {
best = max(best, f[pre][i + half][j + quarter]);
best = max(best, f[pre][i + quarter][j]);
best = max(best, f[pre][i + quarter][j + quarter]);
}
f[cur][i][j] = best;
}
}
swap(pre, cur);
}
// 查询:边长 k 的三角形同样用 6 个边长 block 的块盖住。
// 位置还是构建时那套模板,只把偏移 half 换成 k - block、quarter 换成 cha。
ll answer = 0;
for (int i = 1; i + k - 1 <= n; i++) {
int bottom = i + k - 1;
for (int j = 1; j <= i; j++) {
int right = j + k - 1;
int best = f[pre][i][j];
best = max(best, f[pre][bottom - block + 1][j]);
best = max(best, f[pre][bottom - block + 1][right - block + 1]);
if (lg >= 1) {
int cha = (k - block) / 2;
best = max(best, f[pre][bottom - block + 1][j + cha]);
best = max(best, f[pre][i + cha][j]);
best = max(best, f[pre][i + cha][j + cha]);
}
answer += best;
}
}
cout << answer << '\n';
return 0;
}Python 版是同一个 6 块滚动算法,用 zip + map(max, ...) 把六路取 max 一次写完:
import sys
from array import array
input = sys.stdin.buffer.readline
n, target_size = map(int, input().split())
maximum = [array("i", map(int, input().split())) for _ in range(n)]
size = 1
while size * 2 < target_size:
next_size = size * 2
half = size // 2
maximum = [
array("i", map(max, zip(
maximum[i],
maximum[i + size][:i + 1],
maximum[i + size][size:size + i + 1],
maximum[i + half][:i + 1],
maximum[i + half][half:half + i + 1],
maximum[i + size][half:half + i + 1],
)))
for i in range(n - next_size + 1)
]
size = next_size
offset = target_size - size
half = offset // 2
answer = sum(
sum(map(max, zip(
maximum[i],
maximum[i + offset][:i + 1],
maximum[i + offset][offset:offset + i + 1],
maximum[i + half][:i + 1],
maximum[i + half][half:half + i + 1],
maximum[i + offset][half:half + i + 1],
)))
for i in range(n - target_size + 1)
)
print(answer)复杂度
- 时间:倍增
,查询每个位置 ,合计 。 - 空间:两张
的 int表,, 实测 32~65 MB,与 无关。
解法二:正/倒三角形 DAG 分解(备选)
思路
解法一之所以只要 2 层表,是因为它从没打算把边长
反过来想:如果目标就是「一次把边长
设
当
倒三角形是正三角形的上下镜像,递推公式形状完全对称,所以代码把形状写成 type(
实现要点
- 坐标:位置用
表示( , ),每行按行首地址压成一维数组,省掉三角形区域的空白格子。 - DAG:所有会用到的「(形状,边长)」组合构成一张节点图。边长
是叶子,直接指向原始数据;其余按边长从小到大递推。 - 引用计数 + 用完即释:每个节点记录还有几个父节点会用自己(
use_count),算完一个节点就把两个子节点的计数减一,归零立刻delete[]。靠这一步,峰值才能压到而不是 。 - 求和:根节点就是边长
的正三角形表,把所有位置累加即可。
代码
/**
* Author by Rainboy blog: https://rainboylv.com github: https://github.com/rainboylvx
* rbook: -> https://rbook.roj.ac.cn https://rbook2.roj.ac.cn
* rainboy的学习导航网站: https://idx.roj.ac.cn
* create_at: 2026-10-30 17:12
* update_at: 2026-10-30 17:15
*/
// main2.cpp:P6648 解法二(备选),正/倒三角形 DAG 分解 + 引用计数即时释放。
// 与 main.cpp 的区别:一次性把边长 k 的整张表建出来,补空隙靠倒三角形,
// 代价是同时要持有好几张 O(n^2) 的表。k 很小时时间略优,但内存峰值高。
// 时间 O(n^2 log k),空间 O(n^2);n = 3000、k = 3000 时峰值约 242 MB。
#include <bits/stdc++.h>
using namespace std;
typedef long long ll;
const int MAXK = 3005; // n、k 的上限
const int MAXNODE = 64; // 用到的 (方向, 边长) 组合只有 O(log k) 个,64 够用
// 一个节点就是一张「指定方向、指定边长」的表。
// 正三角形和倒三角形的递推左右对称,所以用 type 区分方向,两套递推各写一份。
struct Node {
int type; // 0 正三角形,1 倒三角形
int s; // 边长
int m; // 坐标满足 x + y <= m,这一层共有 m + 1 行
int p; // 不超过 s 的最大 2 的幂
int d; // d = s - p
int t; // t = 2d - p - 1,中间补的倒三角形边长;<= 0 表示不需要
int dep1; // 同方向的较小块,边长 p
int dep2; // 中间补的反向块,边长 t;-1 表示没有
int use_count; // 还有几个父节点要用这张表,归零就可以释放内存
vector<int> data; // 这一层所有位置上的最大值
};
Node nodes[MAXNODE]; // 节点池,编号从 0 开始
int node_cnt; // 已经建了几个节点
int down_id[MAXK]; // down_id[s]:边长 s 的正三角形的节点编号,-1 表示还没建
int up_id[MAXK]; // up_id[s]:边长 s 的倒三角形的节点编号
int n, k; // 三角形大小、要求的子三角形边长;都不超过 3000,只当长度和下标用
// 边长 m + 1 的三角形一共有多少个位置
int triangle_size(int m) {
return (m + 1) * (m + 2) / 2;
}
// 第 x 行第 0 个数在打包后的一维表里的起点
int row_start(int m, int x) {
return x * (m + 1) - x * (x - 1) / 2;
}
// 不超过 x 的最大 2 的幂
int highest_power_less_than(int x) {
int p = 1;
while ((p << 1) < x) {
p <<= 1;
}
return p;
}
// 建出 (方向 type, 边长 s) 这个节点,并递归建好它依赖的节点;已经建过就直接返回编号
int build_node(int type, int s) {
int &slot = (type == 0 ? down_id[s] : up_id[s]);
if (slot != -1) {
return slot;
}
int id = node_cnt;
node_cnt++;
slot = id;
nodes[id].type = type;
nodes[id].s = s;
nodes[id].m = (type == 0 ? n - s : n - 2 * s + 1);
nodes[id].p = 0;
nodes[id].d = 0;
nodes[id].t = 0;
nodes[id].dep1 = -1;
nodes[id].dep2 = -1;
nodes[id].use_count = 0;
if (s == 1) { // 边长 1 直接就是原始数据
return id;
}
nodes[id].p = highest_power_less_than(s);
nodes[id].d = s - nodes[id].p;
nodes[id].t = 2 * nodes[id].d - nodes[id].p - 1;
nodes[id].dep1 = build_node(type, nodes[id].p);
nodes[nodes[id].dep1].use_count++;
if (nodes[id].t > 0) {
nodes[id].dep2 = build_node(type ^ 1, nodes[id].t);
nodes[nodes[id].dep2].use_count++;
}
return id;
}
// 把节点的表清空,真正把内存还给系统
void release_node(int id) {
nodes[id].data = vector<int>();
}
// 正三角形:3 个边长 p 的同向块盖住三个角,中间那块倒三角空隙用 dep2 补
void compute_down(int id) {
Node &cur = nodes[id];
Node &same = nodes[cur.dep1];
const vector<int> &a = same.data;
cur.data.assign(triangle_size(cur.m), 0);
if (cur.dep2 == -1) {
for (int x = 0; x <= cur.m; x++) {
int len = cur.m - x + 1;
int cur_row = row_start(cur.m, x);
int row1 = row_start(same.m, x);
int row2 = row_start(same.m, x + cur.d);
for (int y = 0; y < len; y++) {
int best = max(a[row1 + y], a[row2 + y]);
best = max(best, a[row1 + y + cur.d]);
cur.data[cur_row + y] = best;
}
}
return;
}
Node &other = nodes[cur.dep2];
const vector<int> &b = other.data;
for (int x = 0; x <= cur.m; x++) {
int len = cur.m - x + 1;
int cur_row = row_start(cur.m, x);
int row1 = row_start(same.m, x);
int row2 = row_start(same.m, x + cur.d);
int row4 = row_start(other.m, x + cur.d - cur.t);
for (int y = 0; y < len; y++) {
int best = max(a[row1 + y], a[row2 + y]);
best = max(best, a[row1 + y + cur.d]);
best = max(best, b[row4 + y + cur.d - cur.t]);
cur.data[cur_row + y] = best;
}
}
}
// 倒三角形:和 compute_down 左右对称,只是三块的位置换成倒三角的三个角
void compute_up(int id) {
Node &cur = nodes[id];
Node &same = nodes[cur.dep1];
const vector<int> &a = same.data;
cur.data.assign(triangle_size(cur.m), 0);
if (cur.dep2 == -1) {
for (int x = 0; x <= cur.m; x++) {
int len = cur.m - x + 1;
int cur_row = row_start(cur.m, x);
int row1 = row_start(same.m, x + cur.d);
int row3 = row_start(same.m, x);
for (int y = 0; y < len; y++) {
int best = max(a[row1 + y + cur.d], a[row1 + y]);
best = max(best, a[row3 + y + cur.d]);
cur.data[cur_row + y] = best;
}
}
return;
}
Node &other = nodes[cur.dep2];
const vector<int> &b = other.data;
for (int x = 0; x <= cur.m; x++) {
int len = cur.m - x + 1;
int cur_row = row_start(cur.m, x);
int row1 = row_start(same.m, x + cur.d);
int row3 = row_start(same.m, x);
int row4 = row_start(other.m, x + cur.p);
for (int y = 0; y < len; y++) {
int best = max(a[row1 + y + cur.d], a[row1 + y]);
best = max(best, a[row3 + y + cur.d]);
best = max(best, b[row4 + y + cur.p]);
cur.data[cur_row + y] = best;
}
}
}
int main() {
ios::sync_with_stdio(false);
cin.tie(nullptr);
memset(down_id, -1, sizeof(down_id));
memset(up_id, -1, sizeof(up_id));
cin >> n >> k;
int base_m = n - 1;
vector<int> base(triangle_size(base_m)); // 原始数据,按 (x, y) 坐标打包成一维
// 读入时把「第 i 行第 j 个」转成两轴坐标:x = j - 1,y = i - j
for (int i = 1; i <= n; i++) {
for (int j = 1; j <= i; j++) {
cin >> base[row_start(base_m, j - 1) + (i - j)];
}
}
int root_id = build_node(0, k);
// 边长 1 的节点直接就是原始数据,两种方向都可能被用到
if (down_id[1] != -1) {
nodes[down_id[1]].data = base;
}
if (up_id[1] != -1) {
nodes[up_id[1]].data = base;
}
base = vector<int>();
// 按边长从小到大递推。p 和 t 都严格小于 s,所以这个顺序本身就是拓扑序,
// 不需要再排序。
for (int s = 2; s <= k; s++) {
for (int type = 0; type <= 1; type++) {
int id = (type == 0 ? down_id[s] : up_id[s]);
if (id == -1) {
continue;
}
if (type == 0) {
compute_down(id);
}
else {
compute_up(id);
}
// 两个子节点各少一个用户;归零说明以后不会再读,立刻释放
int dep1 = nodes[id].dep1;
if (dep1 != -1 && --nodes[dep1].use_count == 0) {
release_node(dep1);
}
int dep2 = nodes[id].dep2;
if (dep2 != -1 && --nodes[dep2].use_count == 0) {
release_node(dep2);
}
}
}
// 根节点存的就是边长 k 的三角形在每个位置上的最大值
ll answer = 0;
for (int value : nodes[root_id].data) {
answer += value;
}
cout << answer << '\n';
return 0;
}复杂度
- 时间:每个节点扫
个位置,节点数 ,合计 。常数比解法一大,因为每张表都要整张写一遍。 - 空间:同时存活的表最多约 6 张
的 int,实测峰值约 242 MB( 时)。
复杂度对比
cin 读入,本机三次取最好:
解法一 main.cpp 时间 |
内存 | 解法二 main2.cpp 时间 |
内存 | |
|---|---|---|---|---|
| 1 | 463 ms | 32 MB | 389 ms | 37 MB |
| 7 | 430 ms | 64 MB | 428 ms | 55 MB |
| 512 | 536 ms | 64 MB | 949 ms | 208 MB |
| 1024 | 662 ms | 63 MB | 1062 ms | 226 MB |
| 3000 | 646 ms | 65 MB | 1101 ms | 242 MB |
读这张表要抓住三点:
- 小
时两者几乎打平。 时读入本身就要三百多毫秒(450 万个整数),两边都得付这笔钱,剩下的差距被压得很小。解法二省掉了「把倍增推到 」那几层,所以 时略快一点,但优势只有几十毫秒。 - 大
时解法二明显落后。它要把边长 的整张表建出来,每张表 36 MB,建表加搬运的写入量远大于解法一的 6 次取 max。 时慢 70%。 - 内存始终是解法一的地盘。解法一只要两层
,实测 32~65 MB 且与 无关;解法二随 涨到 242 MB, 之后差 3 倍以上。内存限制若是 125 MB,解法二直接 MLE。
总结
二维 ST 表不能把一维的“两块覆盖”简单照搬。三角形的特殊形状使得正方向覆盖会出现空隙,补这个空隙有两条路:
- 只用正三角形、用更多块补(解法一,主解):6 块就能填满空隙,滚动保留 2 层,内存稳定且与
无关,易理解,是大多数情况的首选。 - 引入倒三角形(解法二,备选):几何最自然,一次建出
边长的表,但递归分解要同时持有好几张 的表,峰值内存高,在小 时最快。
两者时间复杂度同为