用前缀函数在线性时间输出所有匹配位置,并给出模式串每个前缀的最长 border。
启发题
启发记录: KMP 模板题,前缀函数(pi 数组)和匹配回退的定式
OJ: luogu
题目 ID: P3375
难度:普及+/提高-
标签:KMP前缀函数字符串python
创建: 2026-07-16 19:57
更新: 2026-08-09 06:46
后置题目
roj 3053「Milking Grid」 奶牛矩阵B 的 border_mask 函数直接复用 A 教的「前缀函数记录最长 border、沿 border 链回退」这一步骤(nxt[n], nxt[nxt[n]], … 沿链回溯),把它从求单个最长 border 扩展成枚举全部 border 并压成位掩码,再叠加「周期⟺border」和行、列掩码按位与求公共 border 两步,才把一维模板题升到二维最小覆盖子矩阵。luogu P2375[NOI2014] 动物园B 的滑动 j 失配时沿 pi 链回退正是 A 教的 j=prefix[j-1] border 链回退规则(B 自己也注明与构造 pi 的失配处理完全相同),只在其上叠加 border_count 查表与不重叠约束luogu P3435[POI 2006] OKR-Periods of WordsB 求最短非空 border 直接复用 A 的失配 border 链这一具体步骤:A 退到次长 border 的链式跳转在 B 中被推广为沿 pi 反复跳枚举全部 border,再叠加 mini[i] 继承式递推避免 O(n^2) 跳链。luogu P3318[SDOI2015] 双旋转字符串B 在把双旋转条件化为循环串匹配后,原样复用 A 教的 KMP 找模式串所有出现位置这一步,再叠加哈希查集合luogu P4391[BalticOI 2009] Radio Transmission 无线传输KMP 模板题:先掌握 nxt 数组(最长 border)的本质,才能理解最小正周期公式
题意
输出模式串在文本中的所有出现位置,以及模式串每个前缀的最长真前后缀长度。
思路
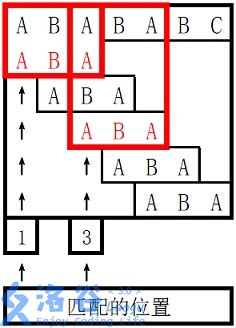
prefix[i] 表示 pattern[:i+1] 的最长 border 长度。计算新位置时,若字符失配,就令 j = prefix[j-1],沿 border 链退到下一个可能长度;每次指针的增加和回退总量都是线性的。
匹配文本时使用相同回退规则。j == m 表示找到一次完整匹配,输出位置后退到模式串的次长 border,从而允许重叠匹配。
Python 知识
- 字符串按
bytes处理时,下标访问直接得到整数,百万字符扫描更省内存。 array("i")只用 4 字节保存一个前缀函数值。- 匹配位置先写入
bytearray,前缀数组再按 8192 个一块输出,避免创建百万个字符串对象。 enumerate(text)同时取得文本下标和字符。
代码
python
import sys
from array import array
text, pattern = sys.stdin.buffer.read().split()
m = len(pattern)
prefix = array("i", [0]) * m
j = 0
for i in range(1, m):
while j and pattern[i] != pattern[j]:
j = prefix[j - 1]
if pattern[i] == pattern[j]:
j += 1
prefix[i] = j
matches = bytearray()
j = 0
for i, character in enumerate(text):
while j and character != pattern[j]:
j = prefix[j - 1]
if character == pattern[j]:
j += 1
if j == m:
matches.extend(f"{i - m + 2}\n".encode())
j = prefix[j - 1]
write = sys.stdout.buffer.write
write(matches)
for start in range(0, m, 8192):
block = " ".join(map(str, prefix[start:start + 8192])).encode()
write((b"" if start == 0 else b" ") + block)
write(b"\n")python
import sys
s1, s2 = [x.decode() for x in sys.stdin.buffer.read().split()]
def find_all(s1,s2):
if not s2 :
return []
ans ,pos = [],s1.find(s2)
while pos != -1:
ans.append(pos+1) # 位置从1开始
pos = s1.find(s2,pos+1)
return ans
def build_prefix(s):
if not s:
return []
pi = [0] * len(s)
j = 0
for i in range(1,len(s)):
while j != 0 and s[i] != s[j]:
j = pi[j-1]
if s[i] == s[j]:
j += 1
pi[i] = j
return pi
def solve():
ans = find_all(s1, s2)
if ans:
print(*ans, sep="\n")
pi = build_prefix(s2)
if pi:
print(*pi, sep=" ")
print(*pi, sep=" ")
if __name__ == "__main__":
solve()main1.py 用 str.find 做匹配,逻辑正确但有两个点会 TLE(全 A 的长串反复调用 find 退化到
纯 Python 实现的 KMP:
python
import sys
s1, s2 = [x.decode() for x in sys.stdin.buffer.read().split()]
def build_prefix(s):
if not s:
return []
pi = [0] * len(s)
j = 0
for i in range(1,len(s)):
while j != 0 and s[i] != s[j]:
j = pi[j-1]
if s[i] == s[j]:
j += 1
pi[i] = j
return pi
def kmp(s1,s2,prefix = []):
if not prefix:
prefix = build_prefix(s2)
equal_pos = []
j = 0
for i in range(0,len(s1)):
while j !=0 and s1[i] != s2[j]:
j = prefix[j-1]
if s1[i] == s2[j]:
j += 1
if j == len(s2):
equal_pos.append(i - len(s2) +1)
j = prefix[j-1]
return equal_pos
def solve():
pi = build_prefix(s2)
pos = kmp(s1,s2,pi)
pos2 = map(lambda x: x+1,pos)
if pos:
print(*(pos2), sep="\n")
print(*pi, sep=" ")
if __name__ == "__main__":
solve()main-kmp.py 用标准 KMP 算法做匹配,代码可读性好,但未做内存优化,百万字符下 Python 对象开销比 main.py 大。
复杂度
| 做法 | 时间 | 空间 |
|---|---|---|
| main.py(KMP + array + 缓冲) | ||
| main-kmp.py(纯 Python KMP) | ||
| main1.py(str.find) |
总结
KMP 的核心不是背循环,而是理解 prefix[j-1] 给出了失配后仍可能匹配的最长前缀。
 。